下载
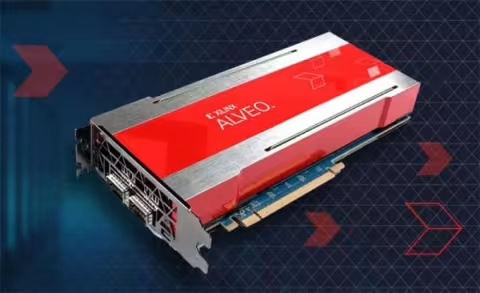
赛灵思 Alveo U200 和 U250 数据中心加速器卡属于符合 PCI Express Gen3 x16 的加速器卡,设计用于加速密集型计算强度应用,包括机器学习、数据分析和视频处理等。部署 Shell 能让该卡通过 PCI Express 板载存储器完成配置。
本白皮书探讨了将赛灵思新 AI 引擎用于计算密集型应用(如 5G 蜂窝和机器学习 DNN/CNN)的架构、应用和优势。
与前几代相比,5G 的计算密度要高 5 到 10倍;AI 引擎已针对 DSP 进行了优化,可满足吞吐量和计算要求,从而提供无线连接所需的高带宽和加速速度。
许多产品中机器学习的采用(通常采用 DNN/CNN 网络的形式)大大增加了计算密度要求。AI 引擎针对线性代数进行了优化,可提供满足这些要求的计算密度,同时与可编程逻辑中执行的类似功能相比,功耗也降低了 50%。
AI 引擎使用了许多程序员所熟悉的 C/C++ 范例进行编程。AI 引擎与赛灵思的自适应与标量引擎集成,可提供高度灵活且功能强大的整体解决方案。
Xilinx® 深度神经网络 (xDNN) 引擎使用 Xilinx® Alveo™ 数据中心加速器卡提供高性能、低时延、高能效的 DNN 加速。通过保持较低能源成本以及最大限度地减少实现过程中所需的特定加速器的数量,可以显著降低总体拥有成本 (TCO)。
赛灵思 Alveo 加速器卡在高性能、高能效、灵活的机器学习 (ML) 推断方面表现出色。xDNN 处理引擎已被开发用于一般执行卷积神经网络 (CNN),如 ResNet50、GoogLeNet v1、Inception v4 - 甚至包含自定义层的 CNN。
本白皮书概述了 xDNN 硬件架构和软件堆栈,以及支持“业界一流”高能效推断声明的基准数据。 为读者提供指导,帮助其实现 Alveo 数据中心加速器卡上的结果再创造。
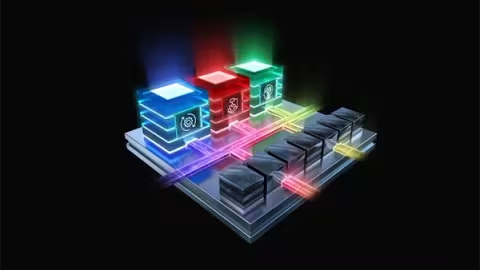
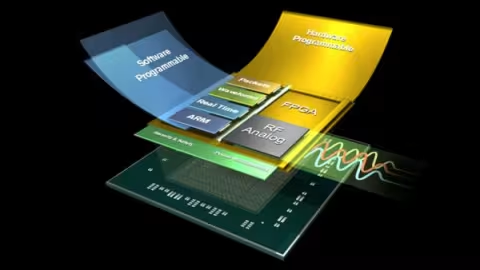
近来涌现的技术挑战迫使业界跳出传统的通用(one-size-fits-all)型CPU标量处理解决方案,进而探讨新的发展方向。大型的矢量处理(DSP-GPU)技术能够解决一些问题,但由于其灵活性欠佳及低效率存储器带宽的使用,导致再次陷入了传统的扩展挑战。传统FPGA解决方案提供可编程存储器层级,但传统的硬件开发流程一直是阻碍数据中心市场等应用领域广泛、大规模采用FPGA的障碍。
该解决方案将所有这三大要素与一个新的工具流相结合,通过单个自适应技术加速平台(ACAP),提供了从框架到C到 RTL级编码的各种不同抽象。赛灵思Versal ACAP作为一大新器件门类,支持用户利用三大可编程要素定制自己的特定领域专用架构(DSA)。
<font color="#FF8000">作者:Ambrose Finnerty, 赛灵思 DSP 技术市场管理部</font>
PCIe 链路训练及稳定性问题形成了绝大多数互联互通问题。
本文档主要介绍在带集成工具的 Xilinx Vivado 设计套件中调试这些问题的使用案例。
本文档将重点介绍如何通过捕获在 UltraScale FPGA Gen3 集成块中用于 PCI Express 内核的链路训练调试信号来使用 Vivado ILA 进行调试。
赛灵思一直是业界主要的 ADAS 传感器方案供应商之一。比如,在前置摄像头方面我们拥有超过 38% 的市场份额。ADAS 系统正在不断的发展和进化,随着 NCAP 等政策法规和标准的推动之下,汽车正从辅助驾驶向自动驾驶过渡,这一趋势就要求更好的相机分辨率、更低的 LiDAR 成本以及响应更迅速,计算能力更强大的信号处理芯片。另外,机器学习以及 AI 的发展将大大加速自动驾驶技术的成熟。赛灵思的 FPGA/SoC 在数据预处理、路径规划、传感器融合和计算加速方面有着得天独厚的优势,因此,基于赛灵思的技术将能帮助机器学习及 AI 更快地部署在汽车应用中,成为构建安全自动驾驶汽车的重要组成部分。
在本次直播课程当中,我们将向您详细讲解及演示基于赛灵思的加速方案是如何帮助客户实现从传统 ADAS 方案演变为更多基于机器学习和 AI 的自动驾驶的。
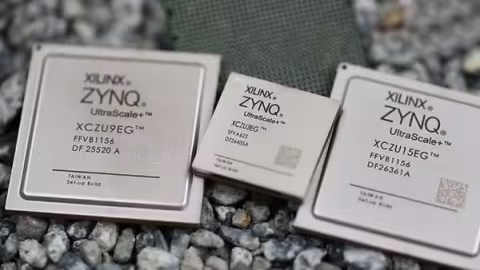
利用Zynq SoC架构上的Python生产力属性,用户可以利用可编程逻辑和微处理器的优势,更轻松地构建人工智能,机器学习和信息技术应用程序设计。