从RTL到Bitstream:FPGA时序与功耗收敛的避坑指南做FPGA,最容易产生一种错觉:仿真通过了,功能跑通了,项目就差不多了。实际上,真正让工程师头疼的往往从这里才开始。这篇就从RTL一路讲到Bitstream,把FPGA时序与功耗收敛过程中最容易踩的坑捋一遍。 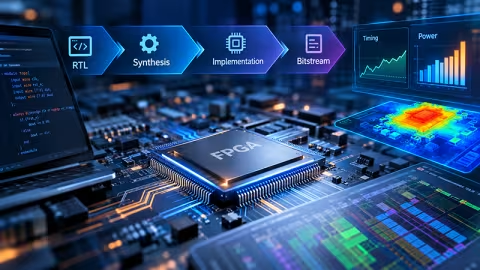
告别DDR抢资源:Andromeda IAE50用“双内存架构”释放FPGA性能异构 Agilex 5 内存架构将带有带外 ECC 的 DDR4 与双通道 LPDDR5 相结合:前者负责系统控制,后者面向高吞吐 FPGA 工作负载 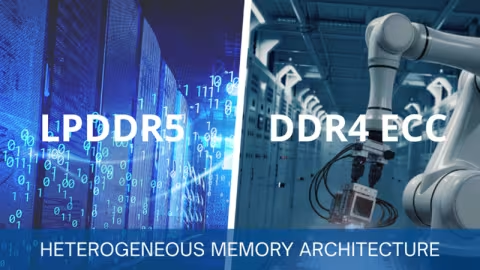
京微齐力 FPGA & HPU:以异构可编程芯片赋能多行业智能化发展当 AI 从云端一路下沉到智能眼镜、机器人乃至每一台终端,端侧设备需要实时感知、实时决策、实时执行,这对芯片的考验不再只是峰值算力,更是功耗、时延、接口与场景适配的综合能力 

国产FPGA“芯”力量!智多晶入选国家级重点“小巨人”
近日,陕西省工业和信息化厅发布的《关于2026年拟支持新一轮第三批、新一轮第一批重点“小巨人”企业名单的公示》已圆满结束。西安智多晶科技股份有限公司(以下简称“智多晶”)凭借在国产FPGA领域的深厚技术积累与产业化成果,正式入选新一轮第三批重点“小巨人”企业名单。
国家级重点“小巨人”是由工业和信息化部与财政部联合遴选认定的国家级荣誉,从已认定的国家级专精特新“小巨人”企业中优中选优,聚焦于掌握关键核心技术、在产业链补短板、锻长板、填空白方面发挥了关键作用。智多晶的入选,意味着公司在国产FPGA芯片的自主创新与产业链安全方面,获得了国家层面的战略级认可。

AMD Kria™ AI 解决方案助力开启自主机器人新纪元Kria AI 在单个生产就绪型模块上集成实时 CPU 控制、快速 GPU 和 NPU 推理能力以及统一内存,主要面向智能体机器人和其他物理 AI 应用。 

一颗低功耗FPGA,如何同时搞定仪表、HUD和电子后视镜?随着智能座舱功能日益复杂,驾驶舱里每一块屏、每一路摄像头,都在对芯片提出新的要求。SoC难以独自高效处理所有任务,显示控制、图像增强、功能安全,每一项都需要专属的硬件能力。怎么办? 

适配英伟达HSB标准 高云半导体推出边缘AI桥接解决方案,助力传感接口无感接入英伟达平台高云半导体基于其GW5AT-60多Sensor接口集成高速SerDes FPGA芯片,推出适配英伟达HSB标准的传感桥接解决方案,为企业提供标准化解决方案,助力用户AI端侧应用的快速落地。 

莱迪思凭借全新AI驱动开发工具Lattice Prompt进一步引领FPGA设计创新Lattice Prompt支持开发人员通过自然语言完成FPGA全设计流程开发,并依托开放的模型上下文协议,对接开发人员选择的大型语言模型和AI智能体集成开发环境,同时在后台自动调度Lattice Radiant运行。 

对话 AMD 酆毅:物理 AI,“从身体到大脑”的跨越日前,在与 AMD 大中华区嵌入式事业部副总裁酆毅( Bob Feng )对话中,当被问及“AMD 在这一轮技术迁移中处于何种位置?”时,他的回答相当简短——“Body-To-Brain,从身体到大脑。” 


思尔芯2026 DVCon巡展收官:以技术创新推动芯片验证左移思尔芯(S2C)深度参与了本届会议在上海、班加罗尔、新竹、横滨等地区的巡回展览,通过多场技术演讲与现场演示,全面展示了其在SoC验证领域的最新成果。 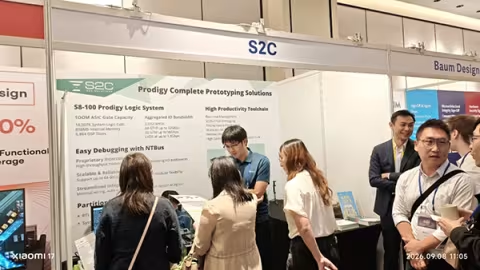
SICK AG 采用 AMD 自适应 SoC 赋能 2D 激光雷达传感器这款传感器主要针对物流应用设计,包括自动导引车( AGV )和移动机器人,其需要在提供卓越精度与响应速度的同时保持价格优势,以立足于成本敏感的全球市场。 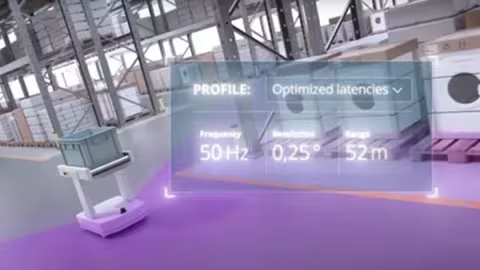
从一颗芯片到一套积木:芯粒如何重构芯片设计芯粒(Chiplet)提供了一条不同的发展路径,将单片设计分解为模块化构建块,这些构建块可在单个封装内组合。今天的集成器件已从分立集成电路(IC)、较简单的专用集成电路(ASIC)或专用标准产品(ASSP) 
告别 hd_visual:用 get_dfx_footprint 高效可视化你的 DFX 设计在 DFX 设计中,理解每个可重配置分区实际占用了哪些硬件资源,是 floorplanning 成功的关键。过去我们依赖 hd_visual 脚本来生成可视化信息——但它有两个致命问题 
Agilex 5 SOC FPGA的HPS端如何响应FPGA端中断(四)——设计中断驱动程序驱动程序采用Linux平台总线(Platform Bus)模型,通过 platform_driver 结构体注册驱动,利用设备树实现设备和驱动的自动匹配。 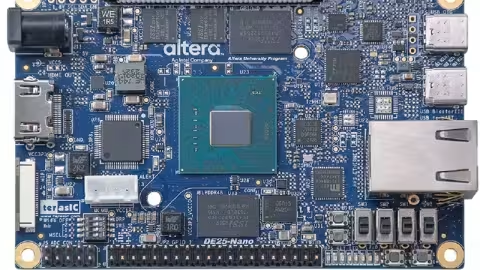
量子计算进入“系统战争”:AMD与Xanadu为何押注量子+经典异构计算量子计算开始需要经典硬件“搭把手”。从3微秒级量子—经典闭环,到CPU、GPU、FPGA协同,AMD与Xanadu正在打开量子计算背后的新基础设施市场。 
FPGA小课堂-使用DDR4控制器实现多通道数据读写(22)在之前我们把dds产生的两个sin波形存储到了ddr4中,接下来需要使用ddr4的读指令将两种波形读取出来。之前写ddr4的功能由0通道和1通道来完成。这次使用通道2和通道3来完成ddr4的读功能。 
15帧/每秒实时“听”出气体泄漏,Mercury+ XU5到底做了什么?64路麦克风实时采集,复杂波束成形持续计算,一台手持式LeakCam600为何需要FPGA SoC?揭秘Mercury+ XU5如何撑起工业声学成像,让设备从“听见泄漏”走向“看见泄漏”。 
优化 VCK190 上 LPDDR4 与 AI 引擎之间的 GMIO 数据流本文探讨了在 AMD Versal™ 评估板 VCK190 上,如何在 AI 引擎全局存储器 I/O (GMIO) 端口与外部存储器(例如 DDR4 和 LPDDR4)之间串流数据时实现最佳吞吐率性能。 
