下载
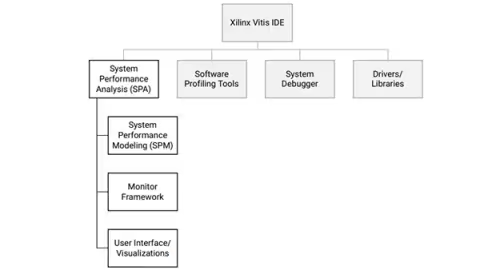
决策树加速器可加速梯度提升树和随机森林算法的推断进程。它能够与通过 XGBoost、LightGBM、Scikit 学习、H2O.ai 和 H2O 无人驾驶 AI 创建的模块协同工作。该软件允许数据科学家和工程师构建快速、可扩展的高成本效益机器学习基础架构,无需改变机器学习框架的使用
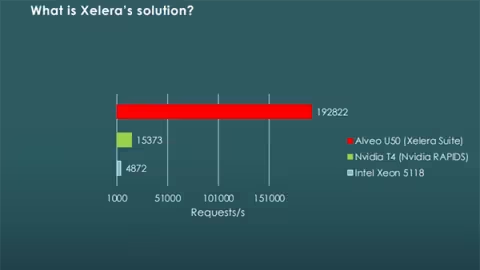
本文描述如何使用 Vivado工具将来自赛灵思 IP 目录的即插即用 IP 模块(包括自定义封装的 IP)添加到您的设计中,并描述如何在设计中使用 IP、创建所需输出文件、管理和升级 IP 以及利用 IP 对设计进行仿真。
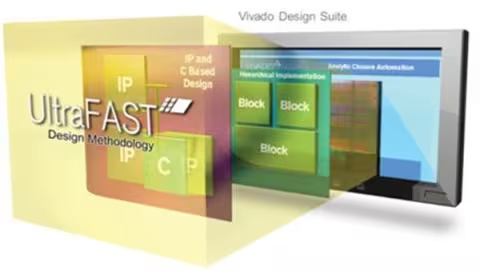
赛灵思可编程器件含有数百万个逻辑单元 (LC),并且集成的现代复杂电子系统也与日俱增。本高效设计方法指南提供了一整套最佳做法,旨在于较短的设计周期内完成此类复杂系统的创建。
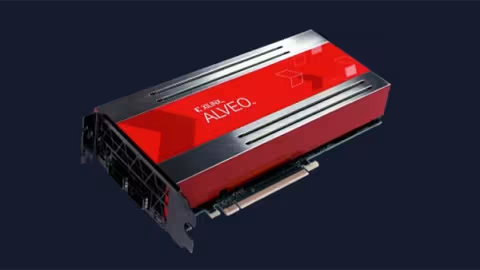
基于 OVS 软件的解决方案不仅是 CPU 密集型的,这会影响系统性能,而且还会阻碍对可用带宽的充分利用。 用户将全部数据包处理功能卸载到 Xilinx Alveo 平台,不仅可节省 CPU 内核,而且还可提高数据包处理性能
PowerAI Vision 使具有深度学习的计算机视觉更易为企业用户所用。现在,您可在 Xilinx® Alveo™ FPGA 上部署 POwerAI Vision 模型,并了解如何将 Vitis™ 库集成至面向 Vision AI 任务的整个工作流程中。
Messaging Classification Appliance(消息分类工具)由 Xilinx 和 Supermicro 合作推出,是一种预封装的软件和硬件解决方案,可通过理解语义内容(消息的含义和意图)实时大规模地过滤、分类和路由消息流。
移动互联网时代,每时每刻都在产生大量的图像和视频内容,内容提供商面临的主要问题是如何实现对内容的有效过滤,避免不允许的内容被公开。睿视演示了一种基于AI+FPGA的图像过滤方法,使用Xilinx Alveo加速器卡对特定图片/视频内容进行有效实时过滤。
本应用说明提供了一个包含控制逻辑的模块,用于将SMPTE UHD-SDI与UltraScale™ GTH收发器耦合,形成一个完整的UHD-SDI接口。本应用说明还提供了一个在Xilinx UltraScale FPGA KCU105评估板上运行的SDI设计示例。
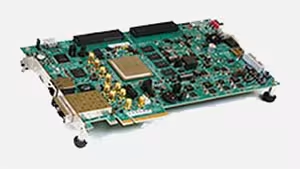
Zynq® UltraScale+™ RFSoC ZCU1275 特性描述套件提供您对集成型 ADC 和 DAC 以及 Zynq UltraScale+ XCZU29DR-2FFVF1760E RFSoC 上提供的 GTY 和 GTR 收发器进行特性描述和评估时所需的一切。
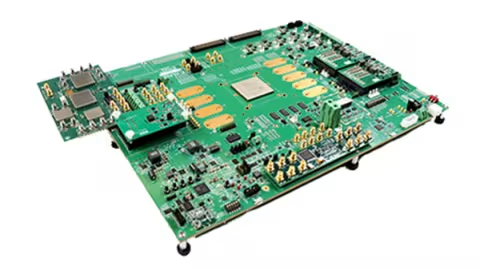
结合机器学习和深度学习实现的 CTR 预估模型,相较于传统机器学习,模型评估指标大幅度提升。通过 FPGA 实现模型的推断过程,大幅度提高吞吐量,降低时延,对互联网公司大规模部署推荐系统节省更多成本。适用于广告 CTR 预估、推荐系统、新零售等场景。 相较于 96vCPU 服务器,雪湖的 FPGA 加速器把吞吐量提高了 2.4 倍,时延降低了 5.7 倍
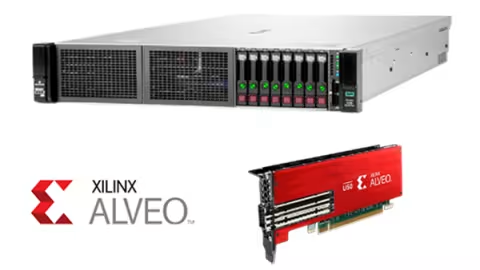
Xilinx 和 Hewlett Packard Enterprise(HPE)建立了最终用户解决方案,该解决方案使用 HPE ProLiant DL385 Gen10 Plus 服务器和第二代 AMD EPYC 处理器实现革命性的性能。
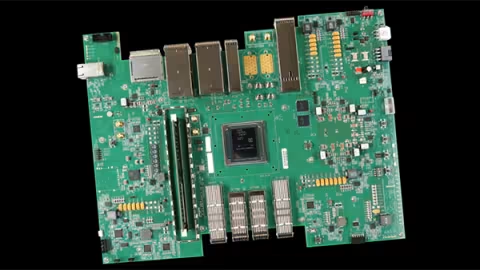
Xilinx VCU129评估套件设计用于Virtex UltraScale+™ XCVU29P-L2FSGA2577EES9818 FPGA,能够评估和开发56G PAM4应用。该评估套件设有多个常见的高速互连、板载存储器以及PCIe Gen 3接口。
Rapanda 提供了在 FPGA 上运行的内联端到端流管道。Rapanda 为即将到来的 Event Tsunami 提供大数据流处理和机器学习的加速。
本文描述了用于实现赛灵思 FPGA 器件资源的有效利用以及在 Vivado® Design Suite 中加速设计实现和时序收敛的推荐设计方法论。提供推荐方法背后的原理,以支持用户制定出明智的设计决策。