快讯
赛灵思公司今天宣布已收购峰科计算解决方案公司( Falcon Computing Solutions ),这是一家为软件应用的硬件加速提供高层次综合( HLS )编译器优化技术的领先私人控股公司。此次收购将通过自动化硬件感知优化增强赛灵思 Vitis™ 统一软件平台,进一步降低软件开发者应用自适应计算的门槛。
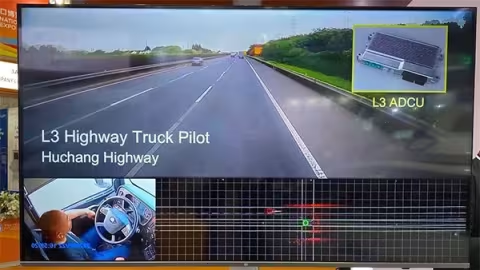
自动驾驶技术是汽车产业与高性能计算芯片、人工智能、物联网等新一代信息技术深度结合的产物,也是未来汽车行业发展的“大势所趋”。成立于 2018 年的宏景智驾便是这个赛道的探险者之一,其软硬一体自动驾驶计算平台是目前中国市场上少有支持高阶自动驾驶的通用型平台解决方案。
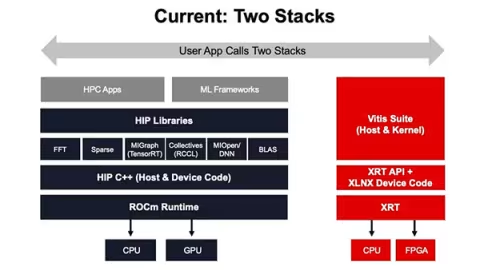
在上周举办的 2020 世界超算大会(SC20)上,赛灵思通过现场演示,展示了赛灵思 Alveo 加速器卡与 AMD ROCm™ 开放软件平台的集成。该技术预演基于 AMD 高性能计算技术领域的领先地位,特别运用了用户模式队列和共享虚拟存储器,在 Alveo 加速器上提供直接、低时延的工作分派。
Ryamax®Smart NIC 支持的云加速解决方案旨在满足 Web 级云和网络需求。通过利用“开放标准、平台和软件定义“的方法,我们提供了从软件到硬件的白盒 Smart NIC 解决方案,以减轻 CPU 负荷并响应实时数据中心网络的服务请求。
Vitis 定量金融 API (L3) 可在您的 C、C++ 或 Python 主机应用中直接调用,非常适合针对 Xilinx 能够为定量金融工作负载带来的性能优势快速进行原型设计和评估。使用这些预先构建的加速器,不需要预先具备硬件设计经验,也不需要学习曲线。
本文通过介绍基于FPGA 研发的超低延时行情系统,对FPGA 硬件设计与实现、延时性能等内容进行深入剖析,希望有助于交易团队、科技公司等相关方进一步探索FPGA的研究和应用,进而提升交易服务质量、改善投资环境。
本次公开课将详细介绍联邦学习,以及针对联邦学习中存在的诸如同态加密、密态运算等复杂计算力问题,结合 FPGA 高并行、高定制、低延迟等特性,分享在联邦学习中具体的 FPGA 加速方案和成果,使得计算性能和效率大幅提升。
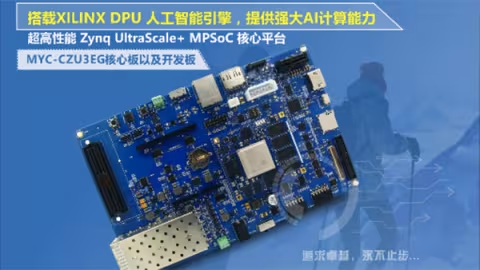
赛灵思宣布推出全功能医疗 X 射线分型深度学习模型和参考设计套件,这是赛灵思与 Spline.AI 及亚马逊网络服务(AWS)强强携手共同取得的合作成果。这种高性能模型部署在赛灵思 Zynq® UltraScale+™ MPSoC ZCU104 器件之上,并采用了赛灵思深度学习处理器单元(DPU)。该 DPU 是一种软 IP 张量加速器,它的强大功能足以支持运行各种神经网络
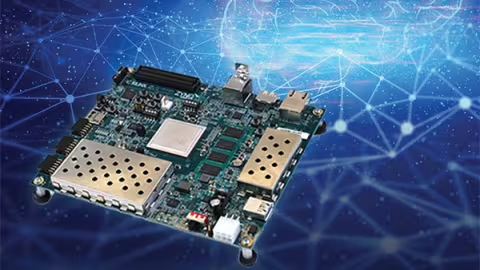
深度学习的突飞猛进,给GPU插上了腾飞的翅膀,英伟达和AMD的显卡成为人工智能的「硬通货」。但是GPU固有的一些缺陷,让它的大规模应用受到约束,更加抗造的FPGA有望成为AI新的「底层建筑」
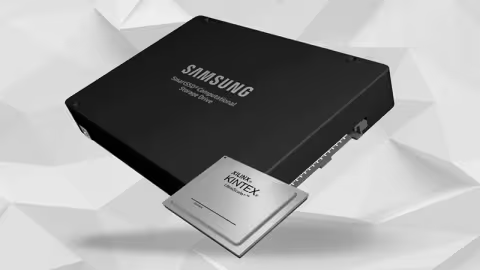
赛灵思公司与三星电子有限公司今日宣布推出三星 SmartSSD® 计算存储驱动器(CSD)。基于赛灵思 FPGA 的 SmartSSD CSD 是业界首款灵活应变的计算存储平台,能够提供数据密集型应用所需的性能、定制能力和可扩展能力。
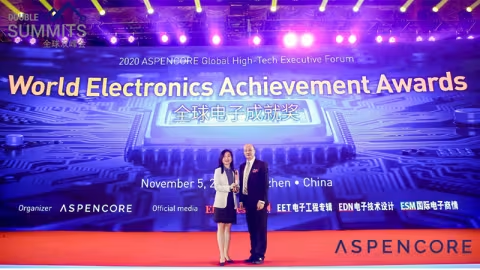
11 月 5 日,致力于加速人工智能推断的赛灵思开发软件平台——Vitis AI,在全球电子工程领域知名媒体机构 ASPENCORE 主办的“2020 全球电子成就奖(World Electronics Achievement Awards,WEAA)”评选活动中,荣膺“2020 全球电子成就奖年度软件/工具”。
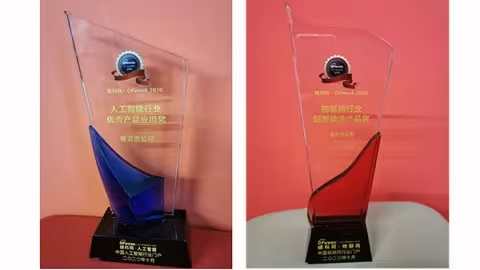
OFweek 2020 第五届“维科杯”评选结果揭晓,赛灵思在人工智能与物联网领域“两开花”—— Vitis AI 与 Zynq SoC / MPSoC 系列产品双双获奖。其中 Vitis AI 斩获维科杯·OFweek 2020 人工智能行业优秀产品应用奖,Zynq SoC/ MPSoC 系列产品荣膺维科杯·OFweek 2020 物联网行业创新技术产品奖。
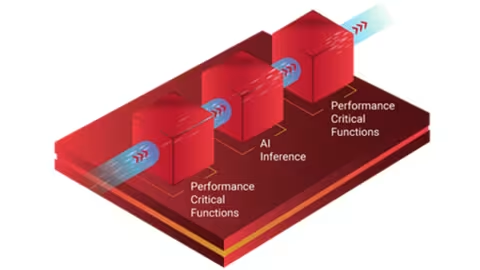
测试系统使用赛灵思 Alveo U250 加速器卡,该卡以 Mipsology 优化的领域专用架构 (DSA) 为基础。基准测试测量了我们基于 Alveo 的定制 DSA 在离线模式下以 5,011 图像/秒的速度执行基于 ResNet-50 基准的图像分类任务的效率。ResNet-50 以图像/秒为单位测量图像分类性能。
在我们所有人的生活和工作因疫情陷入困顿之际,鼓舞我们大多数人继续前行的力量来自于社会与企业合作的一个又一个鲜活的抗疫案例,他们通过各种各样的技术和创新解决方案,助力抗击新冠疫情。与此同时, 新冠疫情也激发着各种新颖应用的加速实现。在此小编想介绍几个赛灵思的客户,他们正在积极开发并交付产品与服务,帮助预防、检测和治疗新冠病毒和其他疾病:
MLPerf 组织最近发布了最新一轮机器学习性能测试结果,首次直接参加此次测试的“新力量” 赛灵思, 在最新 MLPerf 推断基准测试中取得了“图像分类”最高的性能/峰值成绩。TOPS(每秒万亿次运算) 是一个衡量性能效率的指标,意味着在给定 X 个硬件峰值计算量的情况下,赛灵思提供了最高的吞吐量性能。
ASIC 与 FPGA 的嘴仗打了十几年,在 5G 第二波商用浪潮来临之时颇有战况升级的意味。一种声音是:5G 应用的复杂性和标准的不断演进,将使 FPGA 力压 ASIC 用量;另一种声音则是:在成本和功耗压力之下,5G 基站所采用的 FPGA 平台需要向 ASIC 过渡。
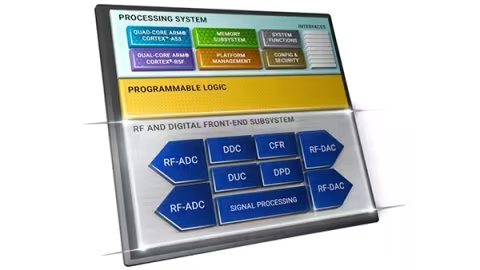
Xilinx® 深度学习处理器单元(DPU)是专用于卷积神经的可配置计算引擎网络。引擎中使用的并行度是设计参数,可以根据需要选择目标设备和应用程序。它包含一组高度优化的指令,并支持大多数卷积神经网络,例如 VGG、ResNet、GoogLeNet、YOLO、SSD、MobileNet、FPN 等
5G的推出速度比之前任何一代无线技术都要快。Omdia的研究显示,5G订阅量在20年第1季度增长了四倍,超过6400万,并有望在2024年底达到100亿。就用户而言,这是4G采用率的4倍。随着5G实施的加速,它们带来了数十亿新的连接设备、数PB的额外网络流量和数百万个新的5G基站。目前全球约有7000万个基站位置。
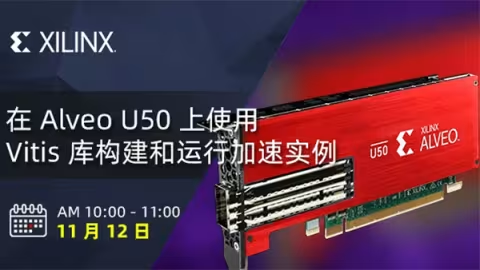
在这个直播课程中,我们将为大家详细介绍 Vitis 加速库,讲解库的构成和分类,以及如何在 Vitis 开发环境及 Xilinx 硬件平台上分层应用最适合的 Vitis 加速库。我们还会以 Alveo U50 加速卡为例,选取 Vitis 加速库中的一个压缩算法 Zlib 为例,详细介绍算法的构成、性能,并实例展示如何在 U50 板卡上实现 Vitis Zlib 算法库。
第三届中国国际进口博览会即将拉开帷幕,致力于“打造灵活应变,万物智能世界”的赛灵思公司,将携手国内外部分合作伙伴,展示一系列先进的平台和解决方案,面向与我们的日常生活息息相关的智能驾驶、智慧工厂、智慧交通、智慧质检,以及智慧物流等智能世界,为开发者及创新者将创意变成现实助力,让我们的生活更加便捷、智慧。