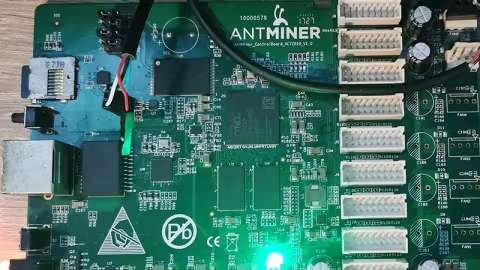
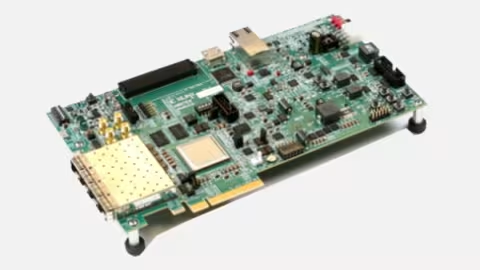
经过前面的实验,我们已经基本摸清楚了Vitis IDE & Vivado的使用方法。在开始构建DPU与深度学习软件栈之前,我们先对我们拿到的开发板做个体检(硬件全面测试),由于大部分深度学习软件框架都是运行在Linux, android或IOS等嵌入式系统上,因此测试完硬件后还需要搭建一个Linux系统以供后续开发使用。
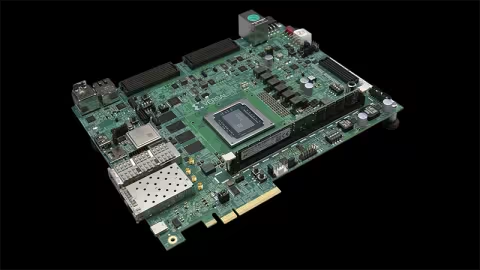
体现 Versal 器件价值主张的参考设计。平台设计包括针对不同市场的视频、机器学习和基于 100G 以太网的 IP。用户可以按原样使用这些设计,也可以根据应用需求对其进行修改。
在博客文章 使用 AXI performance monitors (APM)测试MPSoC DDR访问带宽 中介绍了DDR带宽测试工具"apm_main.elf"。使用过程中,发现还有些不足。它只能测试端口1/2/4/5,只能打印带宽。很多场合需要更多信息。于是更新了这个工具,可以测试所有端口
Versal™ 自适应计算加速平台 (ACAP) 将标量引擎 (Scalar Engine)、自适应引擎 (Adaptable Engine) 和智能引擎(Intelligent Engine) 与领先的存储器和交互技术有机结合,从而为任何应用提供强大的异构加速功能。Versal 架构 PCB 准则已基于前几代进行了精简,以方便 PCB 布局专业人员和硬件设计师使用。
以前设计一个产品时,先要规划好硬件架构,等硬件设计全部完成后,才会开始软件部分的开发,然后才是完整产品的发布。现在,随着云计算、互联网的发展,以及AI、5G和自动驾驶的兴起,硬件和产品的开发流程需求在发生着前所未有的变化,比如更高的硬件性能、更高的安全和保密需求、不断增加的传感器类型和接口、不断演进的AI算法和模型,以及软件开发需要与硬件开发同步进行等等
赛灵思今日于公司虚拟技术大会 Xilinx Adapt 2021 首周宣布,推出功能强大的全新解决方案和 IP,旨在满足其快速壮大的软件、AI 和硬件开发者社区需求。2021 年 11月 16 日,Xilinx Adapt 2021 China 虚拟活动也即将上线。Adapt 2021 China 作为中国专场内容,将面向中国市场、由赛灵思本地发言人、合作伙伴与客户带来众多精彩内容。
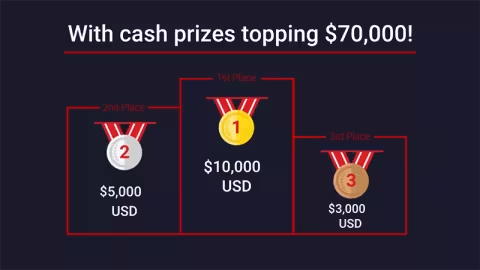
过去两年里,赛灵思通过一系列举措连结开发者群体并取得了长足发展。通过赋能创新自适应计算正成为开发者的强大助力!今天,赛灵思与 Hackster.io 再度向广大开发者群体发起挑战,共同宣布2021 自适应计算挑战赛,来了!
数据中心越来越多地采用人工智能来管理从设备监控到服务器优化的各种任务。基于 FPGA 的自适应计算处于数据中心的核心位置,在许多情况下,是运行复杂 AI 工作负载的最高效、最具成本效益的解决方案。阅读电子书,了解自适应计算如何助力加速。
本文描述了推荐的设计方法,以实现对Xilinx® FPGA器件资源的有效利用,并在Vivado® Design Suite中更快地实现设计和时序收敛。提供了推荐方法背后的原因,以支持和实现明智的设计决策。
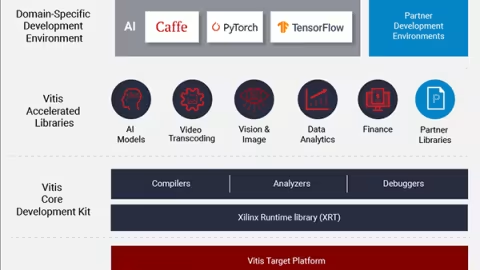
本系列笔记旨在更深入的探索Vitis以及Vitis内部所使用到的技术,本系列主要针对深度学习部署进行探索,比如自定义自己的深度学习硬件平台,深度学习模型量化、模型编译、TVM自动调优,多DPU核异构系统的调度计算等等。
本文通过使用 Design Gateway 的 TOE100G-IP 内核和 NVMeG4-IP 内核,在 Xilinx 的 KCU116 评估套件上演示了 TCP 卸载引擎网络和 NVMe SSD 实现的100Gbps 解决方案。
设计创新型无线通信设备需要跨多个学科密切合作。将算法模型部署到 FPGA 硬件可以快速完成原型设计及无线测试,直接从系统级算法自动生成 HDL 代码则可以消除耗时较长的实现和验证步骤。本白皮书通过一个 5G NR 小区搜索设计来说明该过程,介绍将 MATLAB® 算法和 Simulink® 模型直接转换为适用于 FPGA 的 HDL 的工作流。
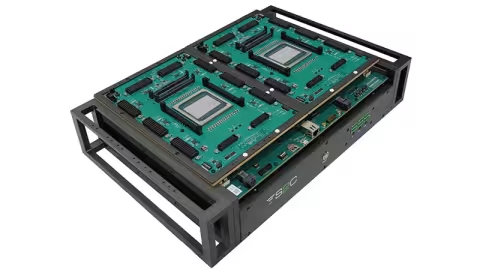
双核S7-VU19P逻辑系统配置了双颗赛灵思 UltraScale+ VU19P FPGA,多套逻辑系统可堆叠或机架部署,以支持更大逻辑规模的设计。搭配芯神瞳协同仿真套件轻松实现将设计链接到原型验证环境,允许大量的事务级数据在 FPGA 与 PC 主机之间进行交互;同时可选配内置的深度调试套件 MDM Pro,用于多颗FPGA的深度调试
本篇博文中的分析是根据真实客户问题撰写的,该客户发现硬件中存在 DDR4 校准错误,不同板以及不同构建 (build) 之间出现的故障并不一致。本篇博文旨在演示用于缩小根本原因范围以及修复此问题的部分调试技巧。