下载
本应用说明提供了一个系统,该系统旨在通过利用每个串行千兆位收发器内的功能来取代外部压控晶体振荡器(VCXO)电路。
本文描述了Vivado®设计套件中使用的电路设计元素,并与带有AI内核的Versal™ ACAP器件相关。元素细节包括VHDL和Verilog实例化代码、原理图符号、真值表以及设计元素的其他特定信息。
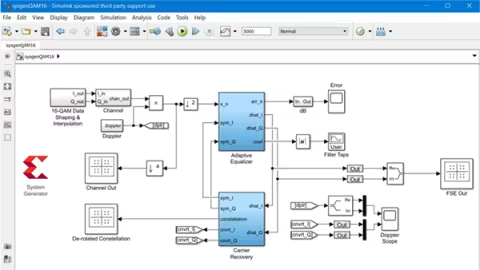
本文描述如何执行基于模型的设计,在 Simulink 环境中实现快速设计探索,并通过自动代码生成加速 Xilinx 器件的生产路径。
对于任何一项设计,要想尽可能实现最低的功率包络,都需要在设计周期早期准确估算功耗。早期估算有助于选择合适的器件、充分发挥架构优势、更改设计拓扑,以及使用不同 IP 块。在设计阶段早期妥善权衡取舍,可以帮助用户在满足规格要求的同时,将自身产品更快速推向市场。本文档旨在介绍如何根据 Versal™ ACAP 架构的描述来使用 Xilinx Power Estimator (XPE)。
赛灵思 Versal™ 自适应计算加速平台 (ACAP) 设计方法论是旨在帮助精简 Versal 器件设计进程的一整套最佳实践。鉴于这些设计的规模与复杂性,因此必须通过执行特定步骤与设计任务才能确保设计每个阶段都能成功完成。本指南将分为以下五大章节,遵循指南里的步骤和最佳实践进行操作,将有助于您以尽可能最快且最高效的方式实现期望设计目标。
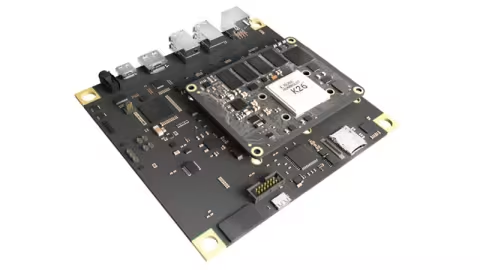
赛灵思 Kria SOM 采用基于加速应用的独特方法,为基于软件的设计提供了全新范例,同时还能助力工业、视觉、医疗与科学市场的应用保持系统级灵活性和 FPGA 性能优势。
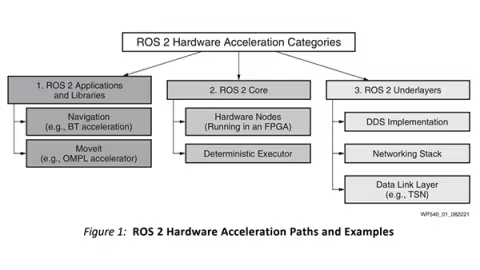
Kria™ 机器人堆栈 (KRS) 是一组集成的机器人库和实用程序,它们使用硬件来加速工业级机器人解决方案的开发、维护和商业化。它采用 ROS 2 作为软件开发工具包 (SDK),并提出了一种以 ROS 2 为中心的开发方法,涵盖从计算图的创建到 Xilinx App Store 中的 ROS 2 覆盖工作区的商业化。
本文记录了Vivado®使用设计运行策略和单个实现命令进行放置和路由的实现功能。详细介绍了用于快速修改现有设计的增量编译流程,以及对信号路由路径进行精确控制的手动路由方法。
体现 Versal 器件价值主张的参考设计。平台设计包括针对不同市场的视频、机器学习和基于 100G 以太网的 IP。用户可以按原样使用这些设计,也可以根据应用需求对其进行修改。
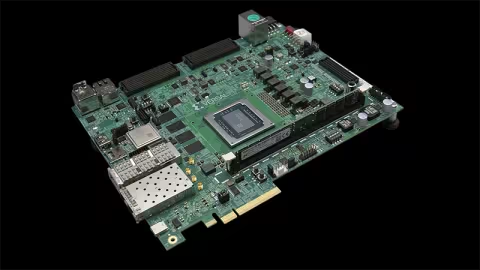
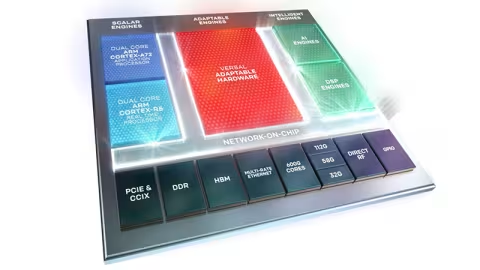
Versal™ 自适应计算加速平台 (ACAP) 将标量引擎 (Scalar Engine)、自适应引擎 (Adaptable Engine) 和智能引擎(Intelligent Engine) 与领先的存储器和交互技术有机结合,从而为任何应用提供强大的异构加速功能。Versal 架构 PCB 准则已基于前几代进行了精简,以方便 PCB 布局专业人员和硬件设计师使用。
数据中心越来越多地采用人工智能来管理从设备监控到服务器优化的各种任务。基于 FPGA 的自适应计算处于数据中心的核心位置,在许多情况下,是运行复杂 AI 工作负载的最高效、最具成本效益的解决方案。阅读电子书,了解自适应计算如何助力加速。
本文描述了推荐的设计方法,以实现对Xilinx® FPGA器件资源的有效利用,并在Vivado® Design Suite中更快地实现设计和时序收敛。提供了推荐方法背后的原因,以支持和实现明智的设计决策。
设计创新型无线通信设备需要跨多个学科密切合作。将算法模型部署到 FPGA 硬件可以快速完成原型设计及无线测试,直接从系统级算法自动生成 HDL 代码则可以消除耗时较长的实现和验证步骤。本白皮书通过一个 5G NR 小区搜索设计来说明该过程,介绍将 MATLAB® 算法和 Simulink® 模型直接转换为适用于 FPGA 的 HDL 的工作流。
本文描述 DPUCAHX8H,这是一种用于具有 HBM 的 Alveo 卡的高吞吐量 CNN 推理 IP。DPUCAHX8H 针对小图像尺寸网络进行了优化。
动态功能交换 (DFX) 在赛灵思芯片内赋能实现了巨大的灵活性,使用户能够按需加载应用,更新已经部署的系统并降低功耗。平台设计方便团队之间的协作,让一个团队专注于基础设施,另一个团队专注于硬件加速。然而,由于 DFX 有基础性的流要求,使得 Vivado 设计套件编译时间拖 长并给多用户环境造成挑战。
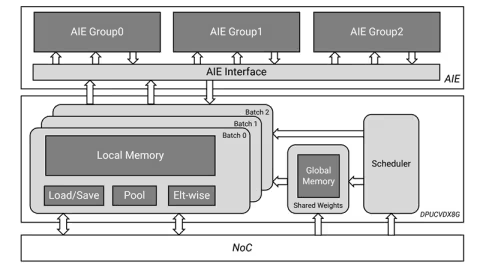
本文介绍 DPUCVDX8G,这是一种可配置的计算引擎,针对具有 AI 引擎的 Versal ACAP 设备中的卷积神经网络进行了优化。