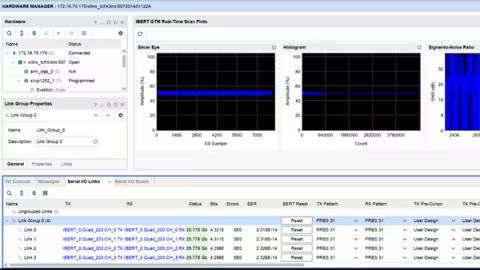
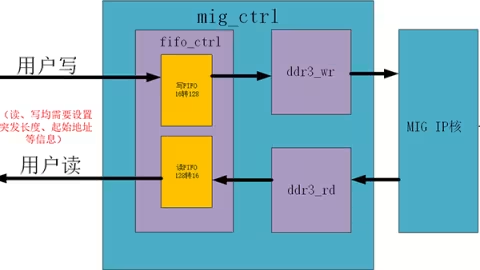
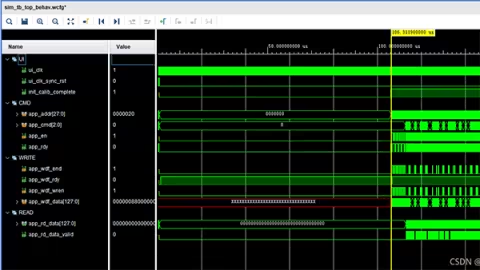
本文将把Xilinx的MIG IP核DDR3的Native接口进行二次封装,将其封装成一个类似FIFO的接口,使其应用起来更加方便简单。
根据IDC最新发布数据,全球人工智能收入预计到2022年同比增长19.6%,达到4328亿美元,包括软件、硬件和服务。预计2023年将突破5000亿美元大关。
Vivado支持工程模式(ProjectBased Mode)和非工程模式(NoneProject Mode)两种,且都能通过Tcl脚本批处理运行。目前,更多的人使用的是工程模式,今天我们就基于工程模式介绍几个Tcl命令的使用方法。
本文描述使用 STARTUPE3 原语的 Virtex® UltraScale™ FPGA 参考设计,通过专用 BPI 接口实现对 VCU108 板载并行 NOR 闪存的配置后读写访问。
该视频介绍了 Aupera 和 Xilinx 在 VCK5000 卡上采用的这种实现方法,以实现完整的视频处理和 ML 推断管道,以及低延迟和高吞吐量的 AI 识别结果。
在Vivado里,可以从Block Design导出TCL脚本,保存工程。之后可以从TCL脚本恢复工程。
VCK5000 开发卡是一款基于 Xilinx Versal 器件的强大加速卡,使用模式与传统 Xilinx Alveo 卡相似。在本视频中,我们将简要介绍在 VCK5000 上的 Vitis 开发步骤。
在我心中,Xilinx是一家完美的公司,技术生态支持实在是做的太好了。Xilinx也知道我们不会用DDR3,所以提供了一个example design给你学习,怎么样?惊不惊喜?意不意外?
本演示视频主要演示运行在 Zynq UltraScale+ MPSoC 上的可编程逻辑的视频处理加速。此外,它还将演示 Xilinx 定向参考设计如何通过在 ZCU102 评估套件中快速启动并运行来缩短客户的设计周期。
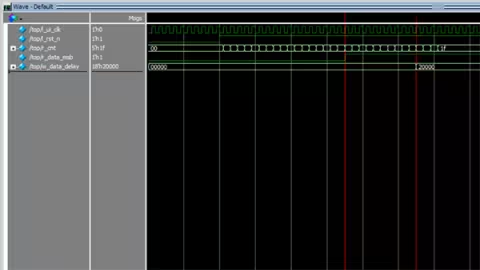
对于xilinx移位寄存器IP的使用而言,其内部为SLR16/SRL32实现。当位深小于32时,其可变延迟是正确的。当大于32,其可变延迟为相同延迟加1。
AMD-赛灵思 AI 团队的论文能在激烈竞争中突出重围,其中一定蕴含着独特的创新与价值。我们与论文第一作者、AMD-赛灵思 AI 团队算法工程师王莉深度对话,为大家带来这份独家的论文解析。